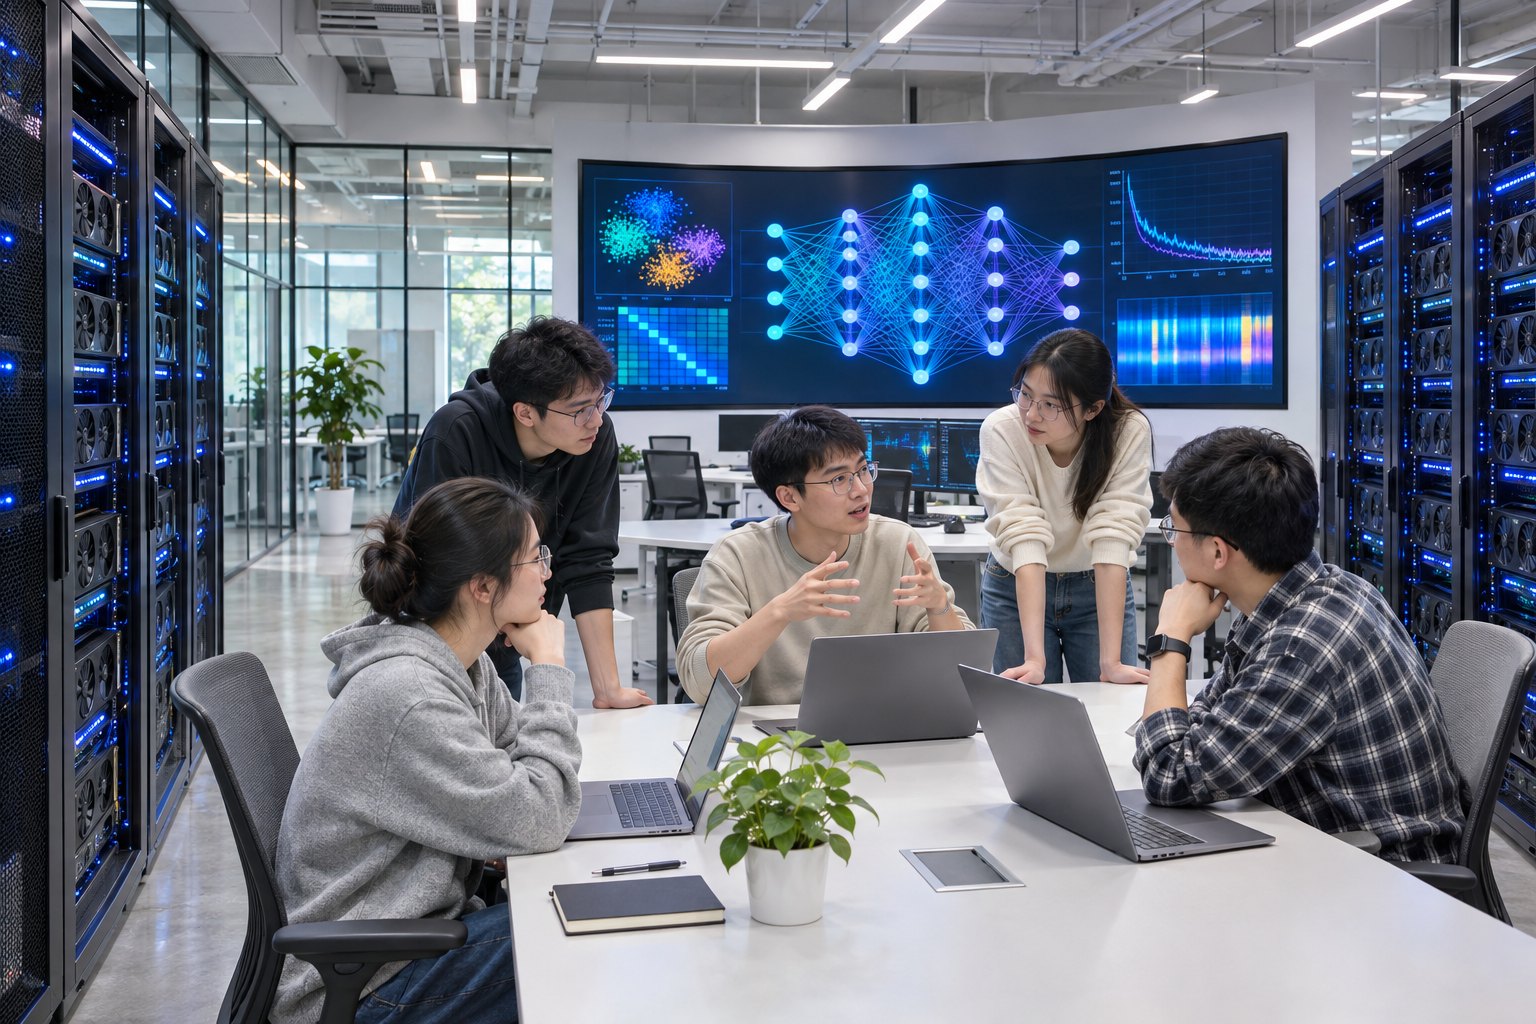
科研中心占地 1,480 ㎡,分为算力机房、开放实验区、课题组研讨室与成果展示区四部分。 所有教学节点接入统一调度平台,学员用校园账号即可申请算力配额 —— 不需要自己买卡、抢机器、配环境。
我们坚持一件事:每个课题都必须跑出可验证的结果。模型精度、推理延迟、显存占用、成本曲线, 四项指标写进结题报告,不接受"跑通了"作为结论。
算力机房 · 教学节点
96 张训练卡、8.6 PB 高速存储、100G 内部互联。配额按课程阶段发放,基础课人人有卡,进阶课题按项目申请。
 Jupyter / SSH 双通道接入
预置 40 余套镜像:PyTorch、TensorFlow、vLLM、DeepSpeed、LLaMA-Factory、ComfyUI、ROS2…… 版本冲突、CUDA 不匹配、依赖地狱,在开课第一天就消失。
| 训练节点 | 8 × GPU / 节点,NVLink 互联,共 12 节点 |
|---|---|
| 单卡显存 | 80 GB HBM,支持 7B–70B 模型全参与 LoRA 微调 |
| 调度平台 | Slurm + 自研配额面板,网页提交任务、查看队列 |
| 开发环境 | JupyterLab / VS Code Remote / 原生 SSH |
| 数据存储 | 个人 200 GB 空间,课题组共享 2 TB |
课题组由全职研究员带队,每组 8–14 名学员。入学第 4 周完成方向选择,第 5 周正式进组。
工业质检缺陷检测、多目标跟踪、遥感地物分割。课题来自制造业与安防合作方,标注数据真实、噪声真实。
行业大模型微调、RAG 知识库、多轮对话评测。学员要交付可上线的问答服务,而不是一个 notebook。
图文对齐、视频理解、扩散模型可控生成。配套 AIGC 工作流实践,从训练到推理部署全链路打通。
电力负荷、供应链需求、设备剩余寿命预测。强调特征工程与业务对齐,模型不是越复杂越好。
量化、蒸馏、剪枝、TensorRT 加速。目标很朴素:让模型在客户那台普通服务器上跑得动。
多智能体协作、工具调用、流程编排。让 AI 真正完成一串任务,而不只是回答一句话。
科研训练按周推进,节奏固定、交付明确。导师不催进度,看板上写着所有人的进度。
导师给出本周实验目标,学员在系统里拆成可执行子任务,估算算力与工时。
跑基线、改结构、调参、记录实验日志。所有实验自动归档,可复现、可对比。
15 分钟讲清"做了什么、结果如何、卡在哪"。同组学员交叉提问,导师现场给方向。
精度、延迟、显存、成本四项指标写进结题报告,代码与权重入库,形成可展示的项目资产。